6 Wiederholung: Bivariate lineare Regression
6.1 Folien
6.2 Daten der heutigen Sitzung
6.3 Code und Ausgaben aus der Vorlesung
Laden der relevanten Pakete
library(report) # Einfaches Erstellen von statistischen Berichten
library(marginaleffects) # Vorhersagen aus Regressionsmodellen
library(performance) # Prüfen der Voraussetzungen
library(tidyverse) # Datenmanagement und Visualisierung: https://www.tidyverse.org/
── Attaching core tidyverse packages ──────────────────────── tidyverse 2.0.0 ──
✔ dplyr 1.2.0 ✔ readr 2.1.6
✔ forcats 1.0.1 ✔ stringr 1.6.0
✔ ggplot2 4.0.2 ✔ tibble 3.3.1
✔ lubridate 1.9.4 ✔ tidyr 1.3.2
✔ purrr 1.2.1
── Conflicts ────────────────────────────────────────── tidyverse_conflicts() ──
✖ dplyr::filter() masks stats::filter()
✖ dplyr::lag() masks stats::lag()
ℹ Use the conflicted package (<http://conflicted.r-lib.org/>) to force all conflicts to become errorsLesen und Aufbereiten des Datensatz von Van Erkel & Van Aelst
d <- haven::read_stata(here::here("data/Vanerkel_Vanaelst_2021.dta")) |>
  rename(
    Political_knowledge = PK,
    Personalized_news = personalized_news,
    Radio = News_channels_w4_1,
    Television = News_channels_w4_2,
    Newspapers = News_channels_w4_3,
    Online_news_sites = News_channels_w4_4,
    Twitter = News_channels_w4_5,
    Facebook = News_channels_w4_6
  ) |>
  mutate(
    Gender = as_factor(Gender),
    Education = as_factor(Education),
    trad = factor(trad, labels = c(
      "traditional news diet: no",
      "traditional news diet: yes"
    ))
  )
Scatterplot
d |>
  ggplot(aes(Age, Political_knowledge)) +
  geom_point() +
  geom_smooth(method = "lm", se = FALSE, linewidth = 2) +
  xlim(c(18, 72)) +
  scale_y_continuous(breaks = 0:5, limits = c(-0.3, 5.3)) +
  theme_classic(base_size = 12)
`geom_smooth()` using formula = 'y ~ x'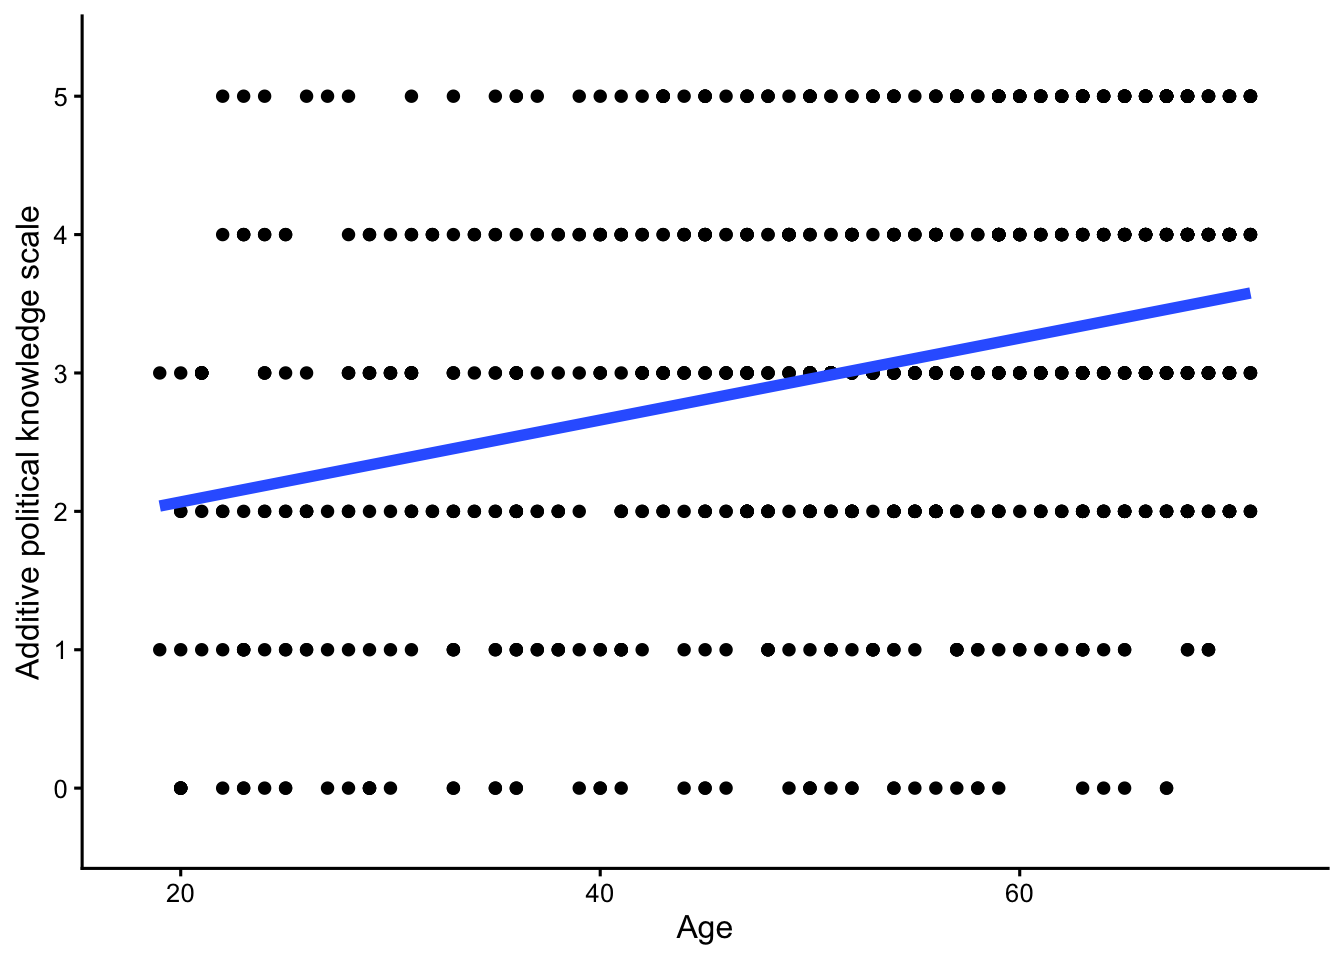
Jittered scatterplot
jit_scat <- d |>
  ggplot(aes(Age, Political_knowledge)) +
  geom_jitter(width = 0.3, height = 0.3) +
  geom_smooth(method = "lm", se = FALSE, linewidth = 2) +
  xlim(c(18, 72)) +
  scale_y_continuous(breaks = 0:5, limits = c(-0.3, 5.3)) +
  theme_classic(base_size = 12)
jit_scat
`geom_smooth()` using formula = 'y ~ x'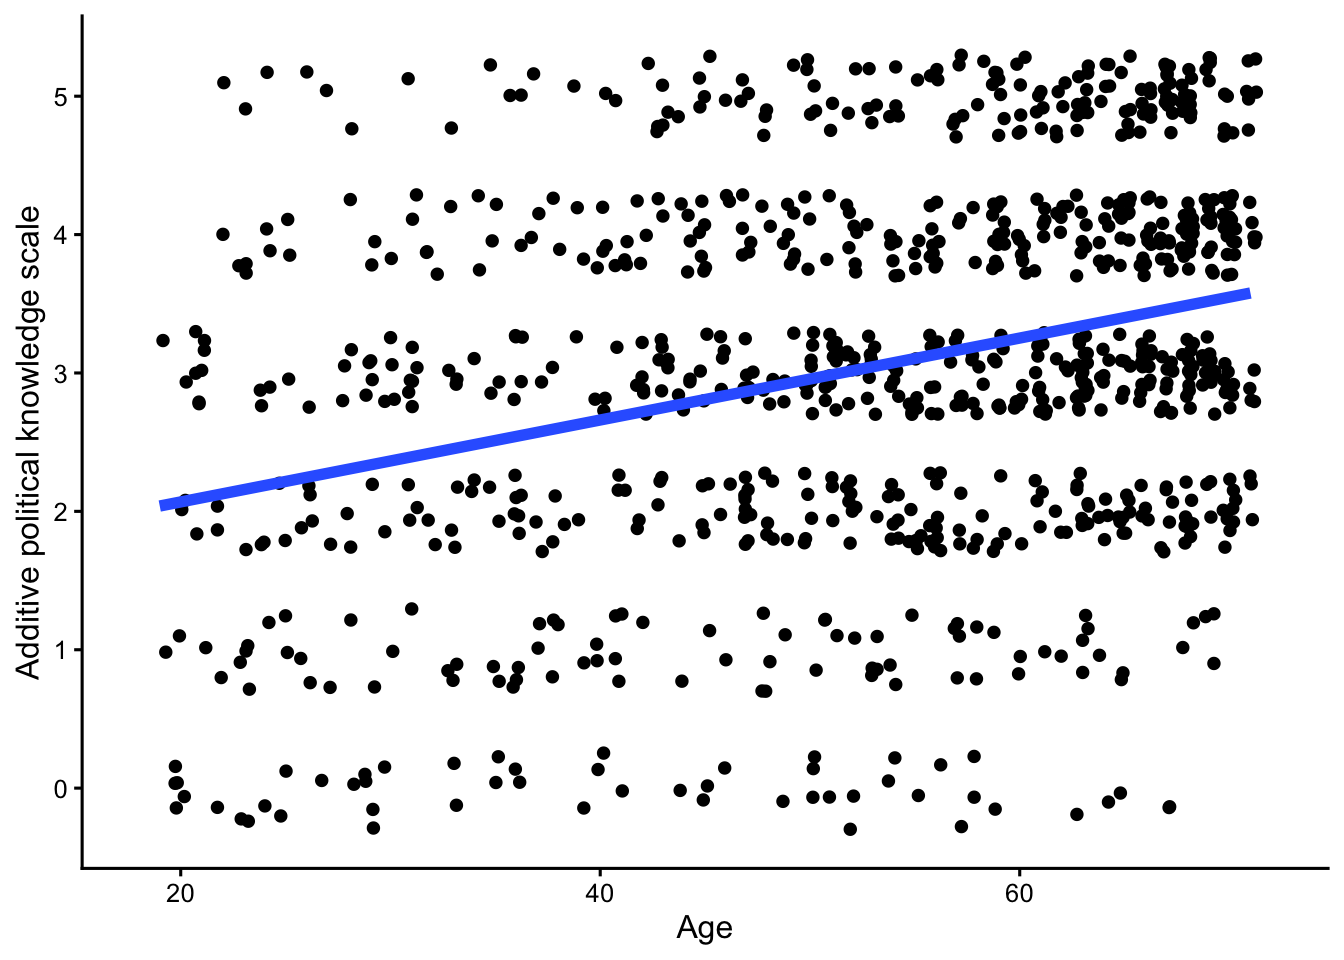
Regression Politisches Wissen und Alter schätzen
m_pk_age <- lm(Political_knowledge ~ Age, data = d)
m_pk_age
Call:
lm(formula = Political_knowledge ~ Age, data = d)

Coefficients:
(Intercept)          Age
     1.4761       0.0296
Regression mit Z-standardisierten Variablen zum Vergleich mit Korrelationskoeffizienten
lm(scale(Political_knowledge) ~ scale(Age), data = d)
Call:
lm(formula = scale(Political_knowledge) ~ scale(Age), data = d)

Coefficients:
(Intercept)   scale(Age)
  1.489e-16    3.034e-01
Korrelation
cor(d$Political_knowledge, d$Age)[1] 0.3033832Regressionstabelle mit Inferenzstatistik
lm(Political_knowledge ~ Age, data = d) |>
  report_table(metrics = "R2")
Parameter | Coefficient | 95% CI | t(991) | p | Std. Coef.
-----------------------------------------------------------------------
(Intercept) | 1.48 | [1.16, 1.79] | 9.12 | < .001 | 5.13e-16
Age | 0.03 | [0.02, 0.04] | 10.02 | < .001 | 0.30
| | | | |
R2 | | | | |
Parameter | Std. Coef. 95% CI | Fit
--------------------------------------
(Intercept) | [-0.06, 0.06] |
Age | [ 0.24, 0.36] |
| |
R2 | | 0.09Korrelationskoeffizient mit Inferenzstatistik
cor.test(~ Political_knowledge + Age, data = d) |>
  report_statistics()
In the report() function, for htest objects, you can try providing the
data argument manually, e.g., report(x, data = data).r = 0.30, 95% CI [0.25, 0.36], t(991) = 10.02, p < .001
Vorhersagen Tabelle
m_pk_age |>
  avg_predictions(variables = list(Age = "threenum")) # "threenum" = Vorhersage für M-SD, M, M+SD
  Age Estimate Std. Error    z Pr(>|z|)   S 2.5 % 97.5 %
 39.0     2.63     0.0583 45.1   <0.001 Inf  2.52   2.75
 53.0     3.04     0.0412 73.9   <0.001 Inf  2.96   3.13
 66.9     3.46     0.0583 59.3   <0.001 Inf  3.34   3.57

Type: response
Vorhersagen Plot
theme_set(theme_classic(base_size = 12)) # Layout für Plot
m_pk_age |>
  plot_predictions(condition = list(Age = "threenum"))
Regression mit binärem Prädiktor Gender
lm(Political_knowledge ~ Gender, data = d) |>
  report_table(include_effectsize = FALSE, metrics = "R2")
Parameter | Coefficient | 95% CI | t(991) | p | Fit
-----------------------------------------------------------------------
(Intercept) | 3.44 | [ 3.33, 3.55] | 60.48 | < .001 |
Gender [female] | -0.84 | [-1.00, -0.67] | -10.14 | < .001 |
| | | | |
R2 | | | | | 0.09T-Test zum Gruppenvergleich nach Gender
t.test(Political_knowledge ~ Gender, data = d, var.equal = FALSE) |>
  report_table(data = d)
Welch Two Sample t-test
Parameter | Group | Mean_Group1 | Mean_Group2 | Difference
---------------------------------------------------------------------
Political_knowledge | Gender | 3.44 | 2.61 | 0.84
Parameter | 95% CI | t(987.31) | p | Cohen's d | Cohen's d CI
-----------------------------------------------------------------------------------
Political_knowledge | [0.67, 1.00] | 10.15 | < .001 | 0.64 | [0.52, 0.77]
Alternative hypothesis: two.sidedUeberpruefung von Linearitaet Normalverteilung Homoskedastizitaet Ausreisser in einem Befehl
check_model(m_pk_age, check = c("linearity", "normality", "homogeneity", "outliers"))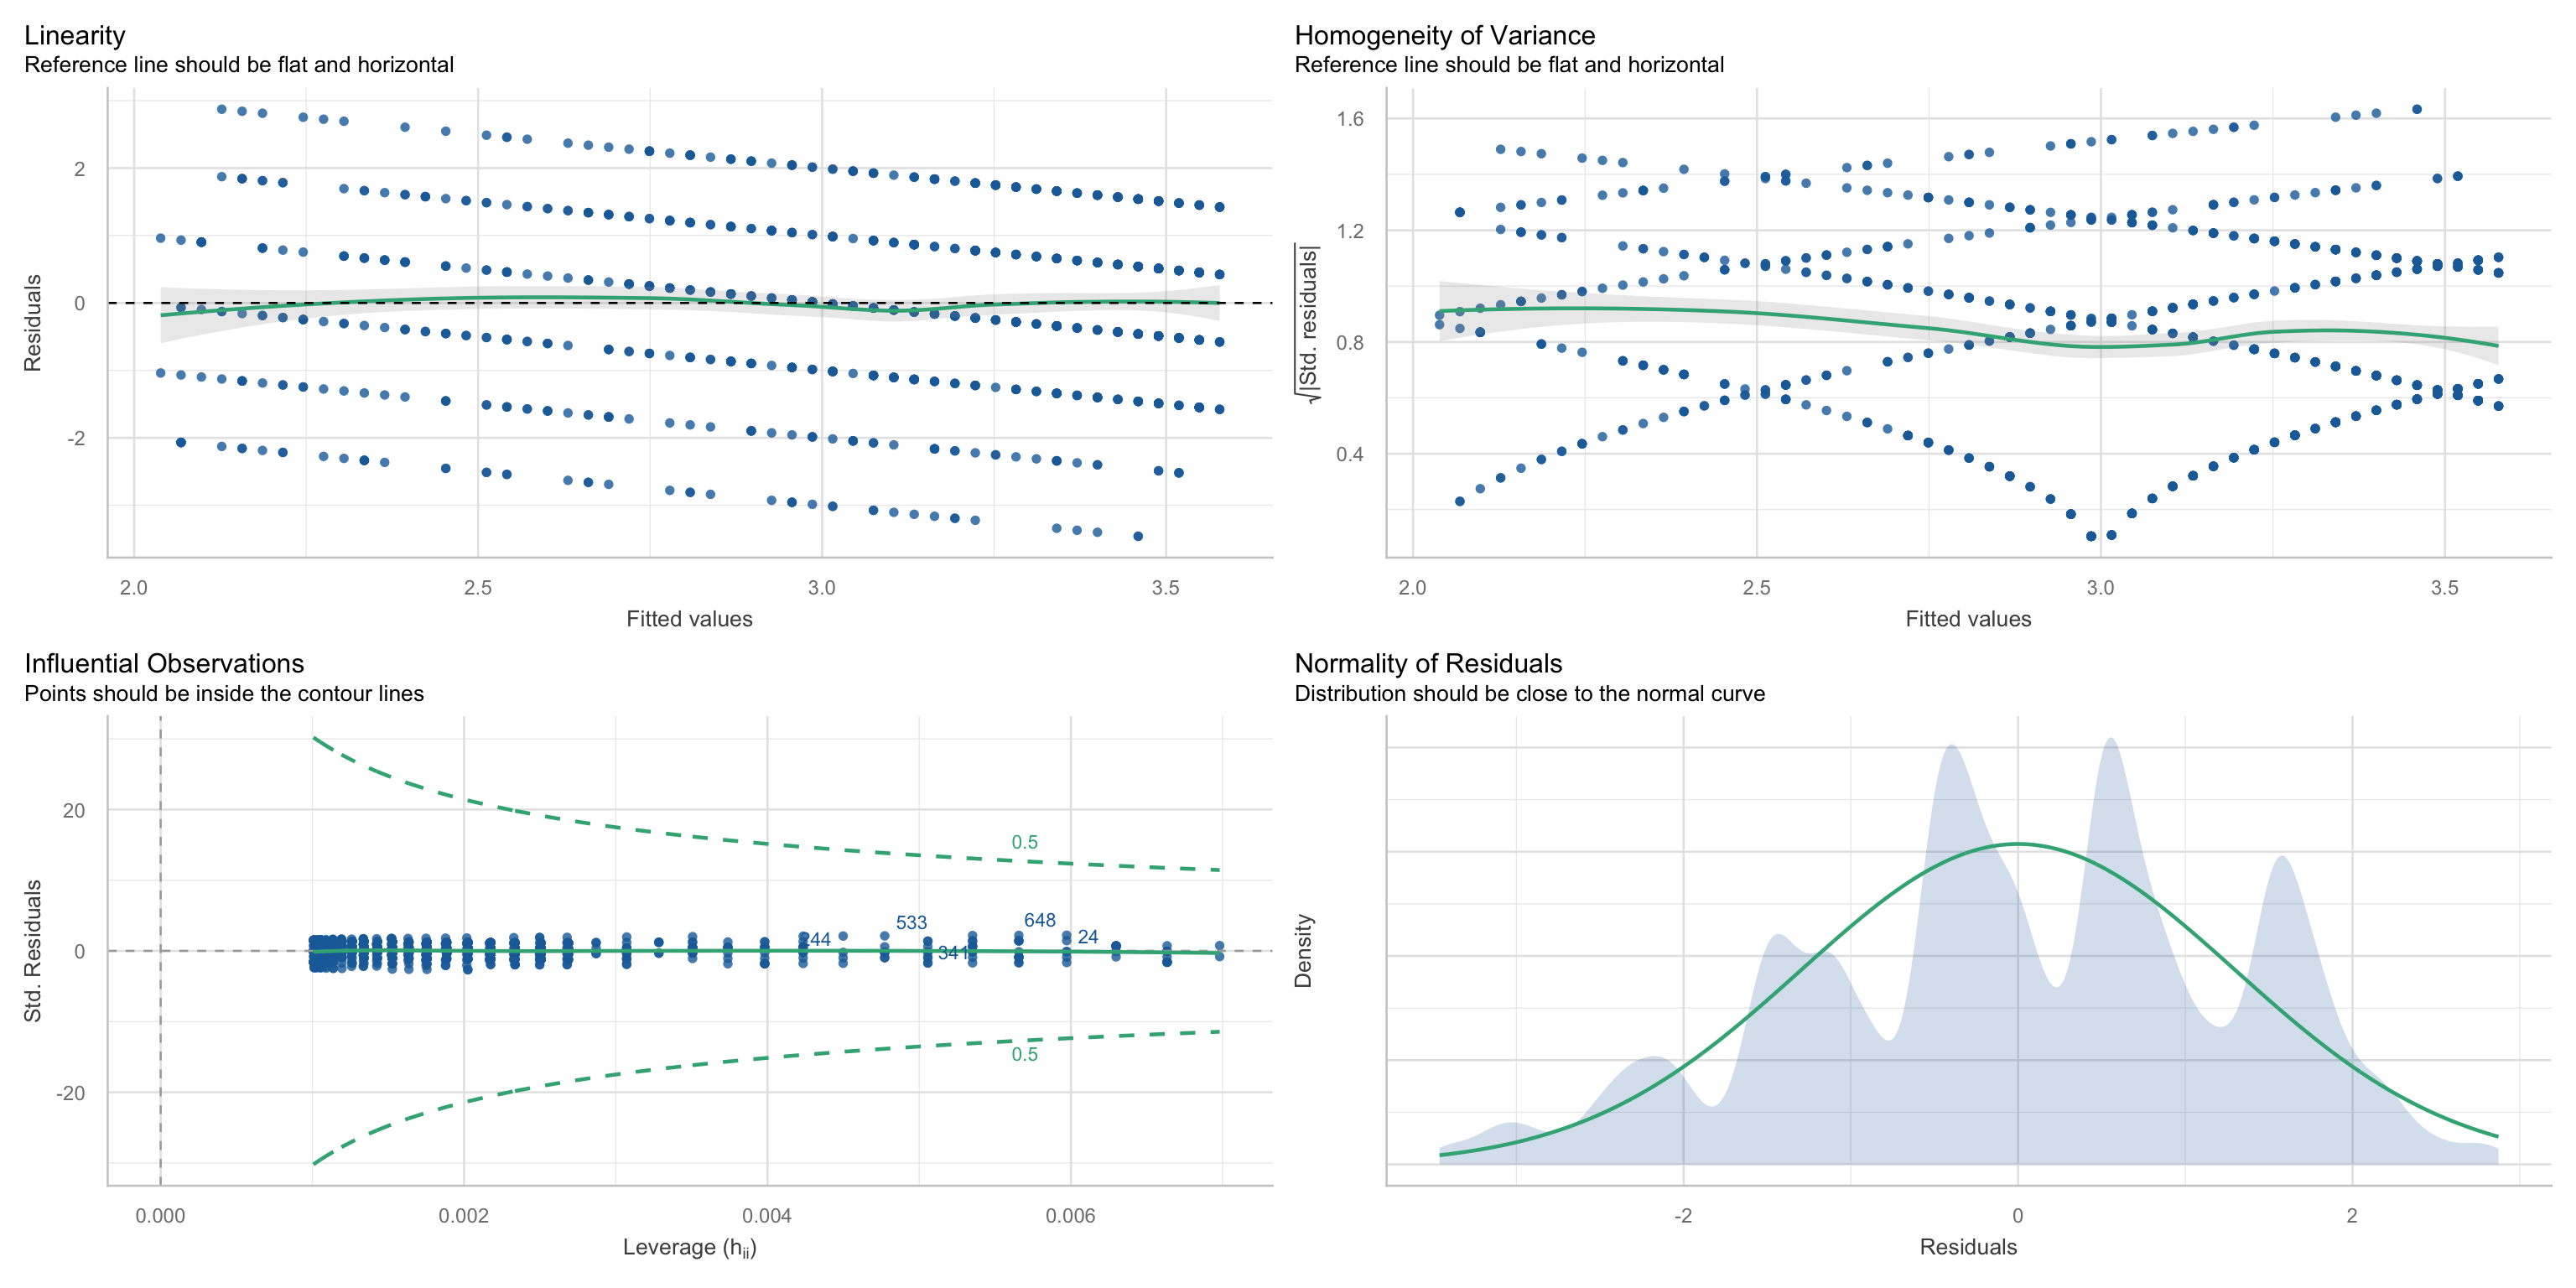
Ueberpruefung Linearitaet
check_model(m_pk_age, check = "linearity", panel = FALSE) |> plot()$NCV
Ueberpruefung Normalverteilung Homoskedastizitaet
check_model(m_pk_age, check = c("normality", "homogeneity"))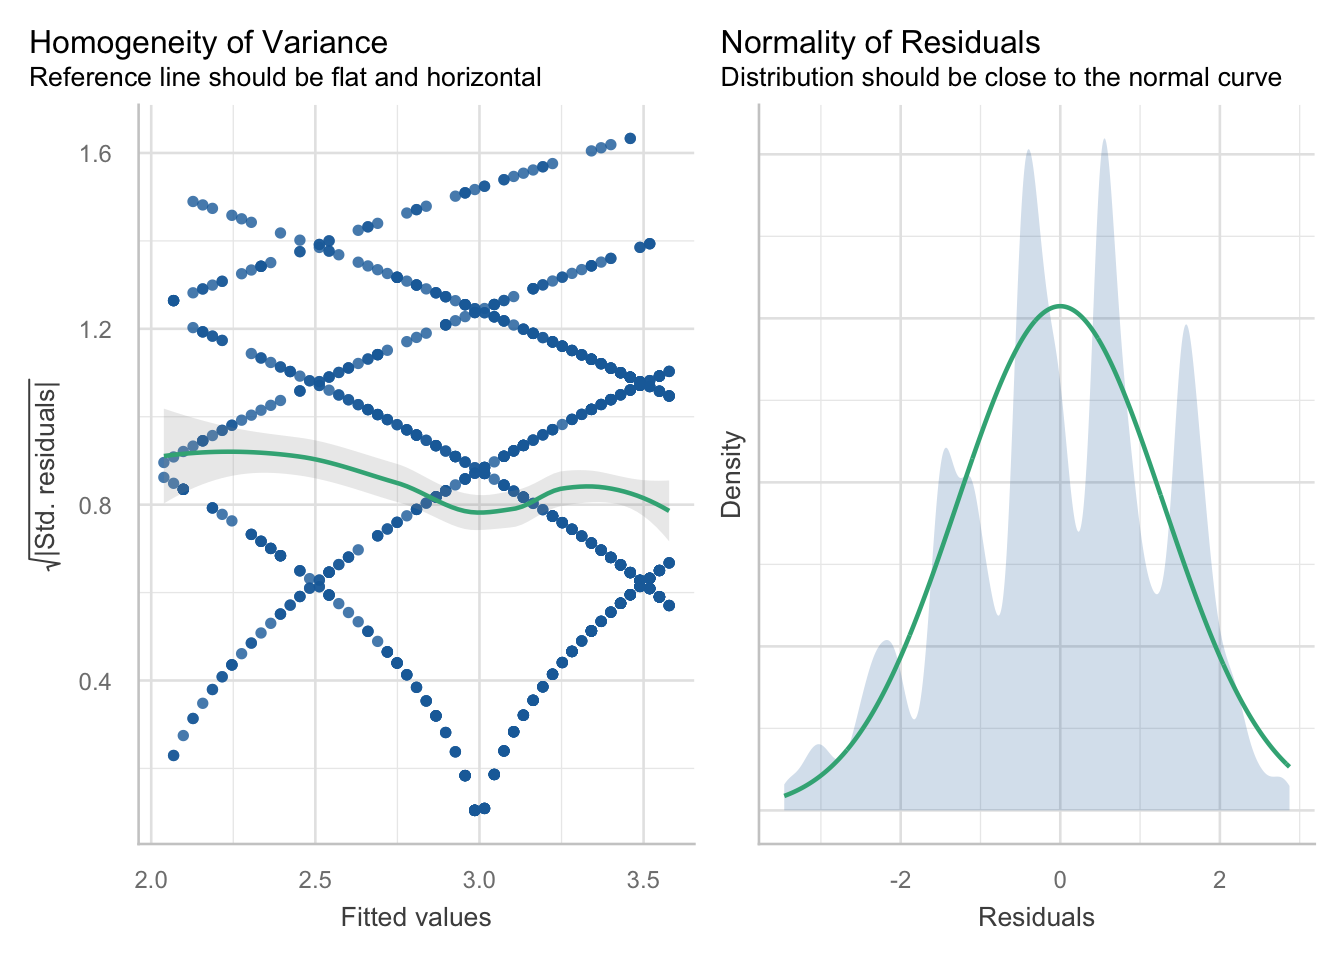
Ueberpruefung Unabhaengigkeit der Residuen
check_residuals(m_pk_age) |> plot()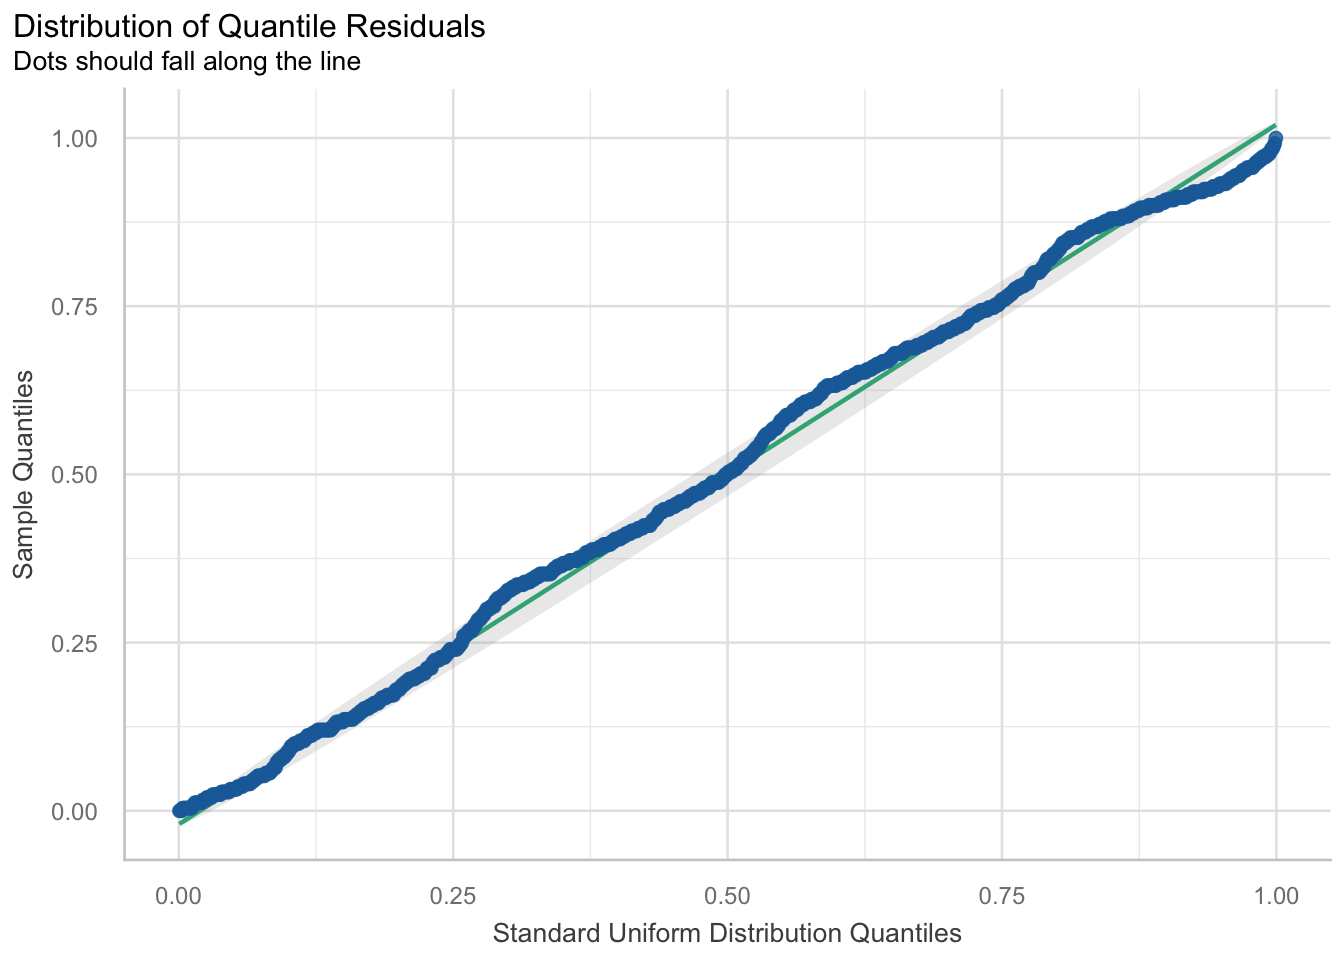
Ueberpruefung Ausreisser
check_outliers(m_pk_age) |> plot()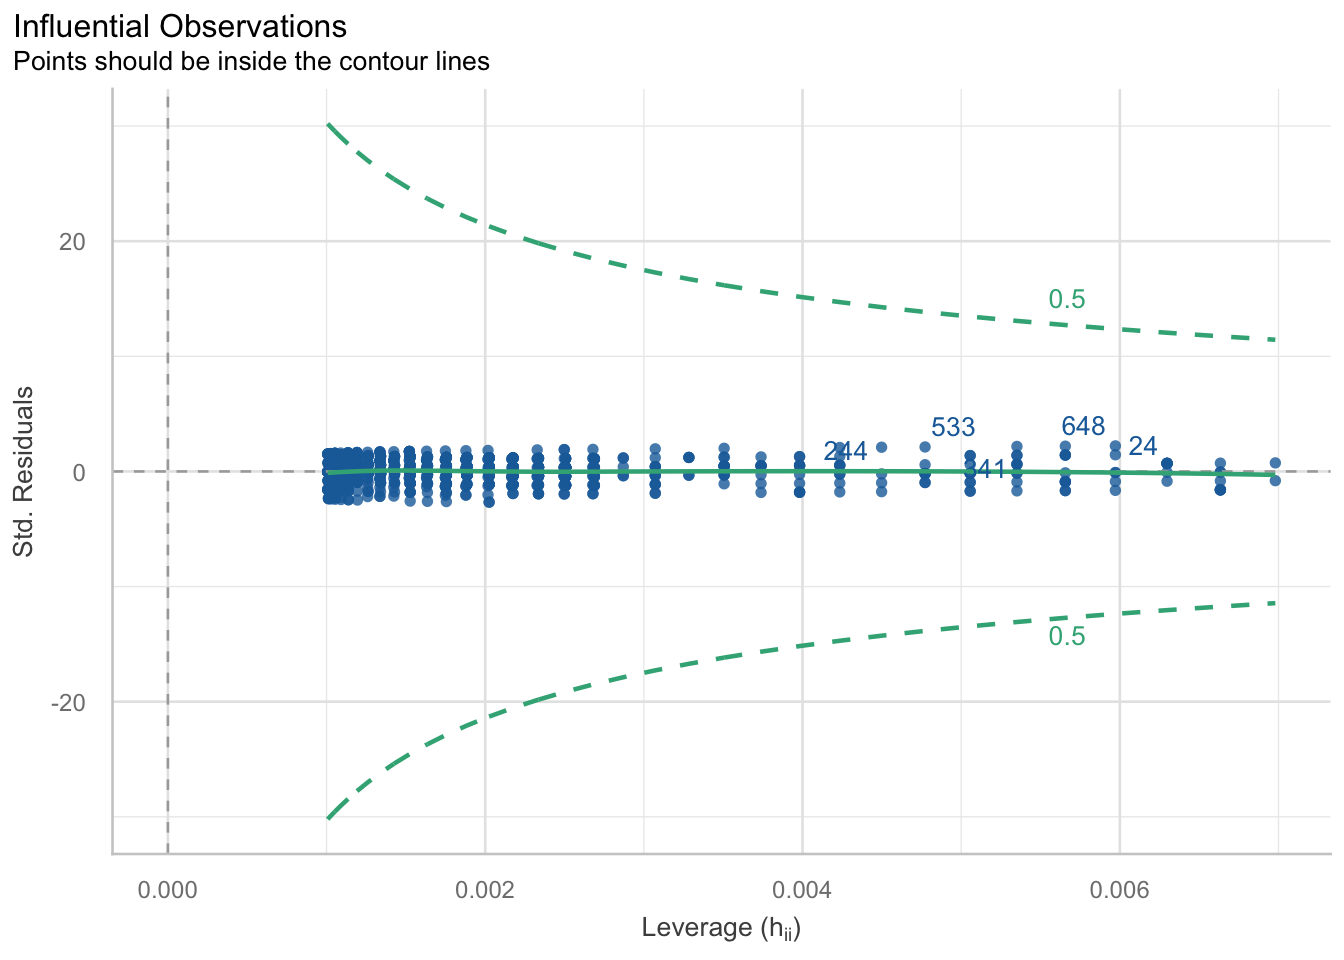
Zentrieren um Mittelwert
d <- d |>
  mutate(Age_c = Age - mean(Age))
Zentrieren um Mittelwert Plot
theme_set(theme_classic(base_size = 12))
d |>
  ggplot(aes(Age, Age_c)) +
  geom_point()
Regression Original zum Vergleich
m_pk_age |>
  report_table(metrics = "R2", include_effectsize = FALSE)
Parameter | Coefficient | 95% CI | t(991) | p | Fit
-----------------------------------------------------------------
(Intercept) | 1.48 | [1.16, 1.79] | 9.12 | < .001 |
Age | 0.03 | [0.02, 0.04] | 10.02 | < .001 |
| | | | |
R2 | | | | | 0.09Regression mit zentriertem Prädiktor
lm(Political_knowledge ~ Age_c, data = d) |>
  report_table(metrics = "R2", include_effectsize = FALSE)
Parameter | Coefficient | 95% CI | t(991) | p | Fit
-----------------------------------------------------------------
(Intercept) | 3.04 | [2.96, 3.13] | 73.88 | < .001 |
Age c | 0.03 | [0.02, 0.04] | 10.02 | < .001 |
| | | | |
R2 | | | | | 0.09Alter in 10-Jahres-Schritten
d <- d |>
  mutate(Age_10 = Age / 10)
Alter in 10-Jahres-Schritten Plot
d |>
  ggplot(aes(Age, Age_10)) +
  geom_point()
Regression mit Alter in 10-Jahres-Schritten als Prädiktor
lm(Political_knowledge ~ Age_10, data = d) |>
  report_table(metrics = "R2", include_effectsize = FALSE)
Parameter | Coefficient | 95% CI | t(991) | p | Fit
-----------------------------------------------------------------
(Intercept) | 1.48 | [1.16, 1.79] | 9.12 | < .001 |
Age 10 | 0.30 | [0.24, 0.35] | 10.02 | < .001 |
| | | | |
R2 | | | | | 0.09Z-Standardisierung
d <- d |>
  mutate(
    Age_z = (Age - mean(Age)) / sd(Age),
    Political_knowledge_z = scale(Political_knowledge, center = TRUE, scale = TRUE)
  )
Z-Standardisierung Plot Alter
d |>
  ggplot(aes(Age, Age_z)) +
  geom_point()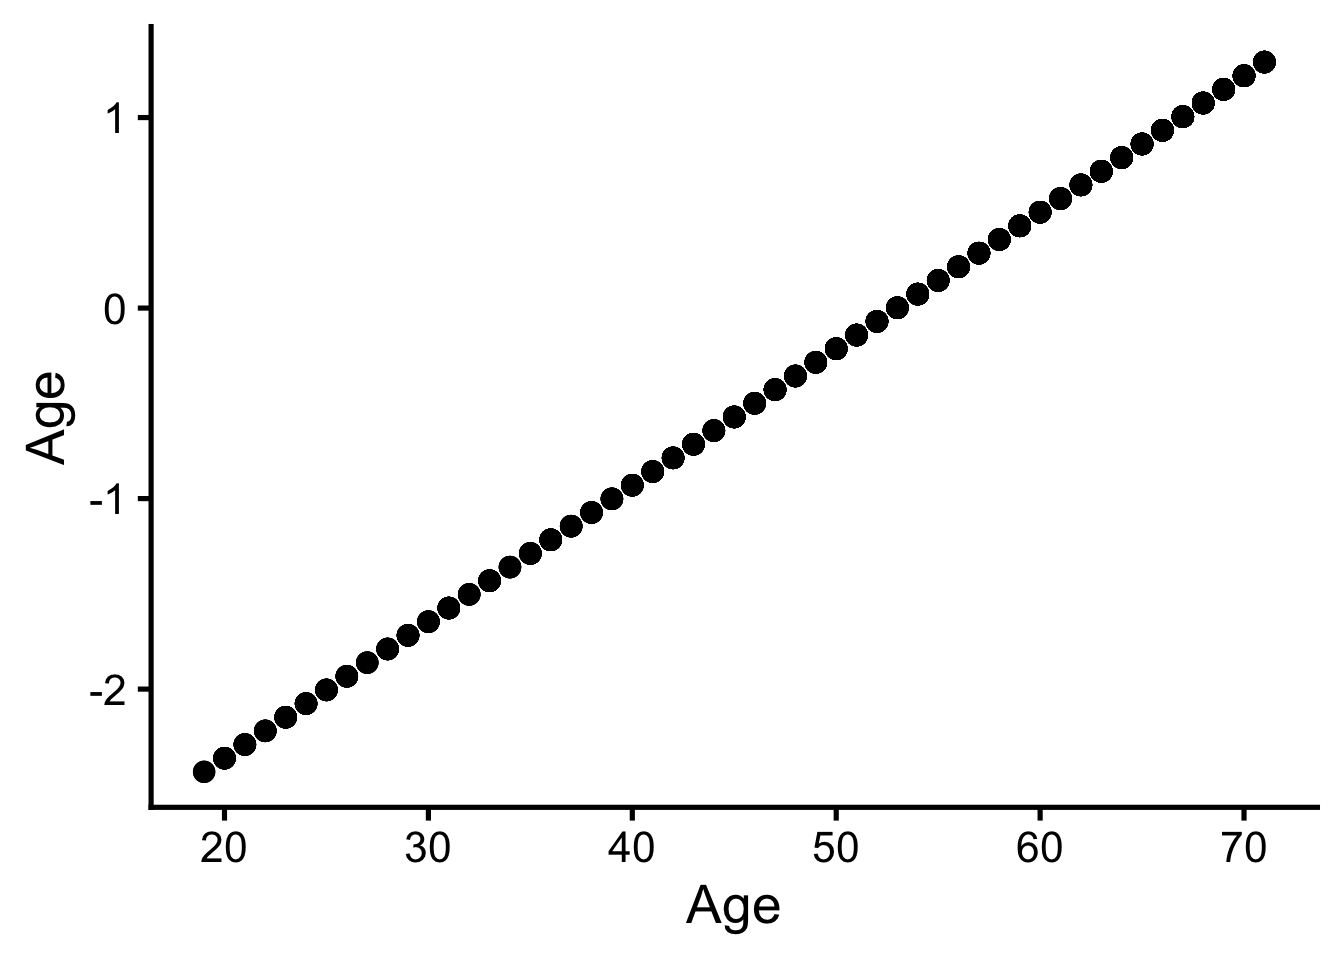
Z-Standardisierung Plot Politisches Wissen
d |>
  ggplot(aes(Political_knowledge, Political_knowledge_z)) +
  geom_point(size = 8)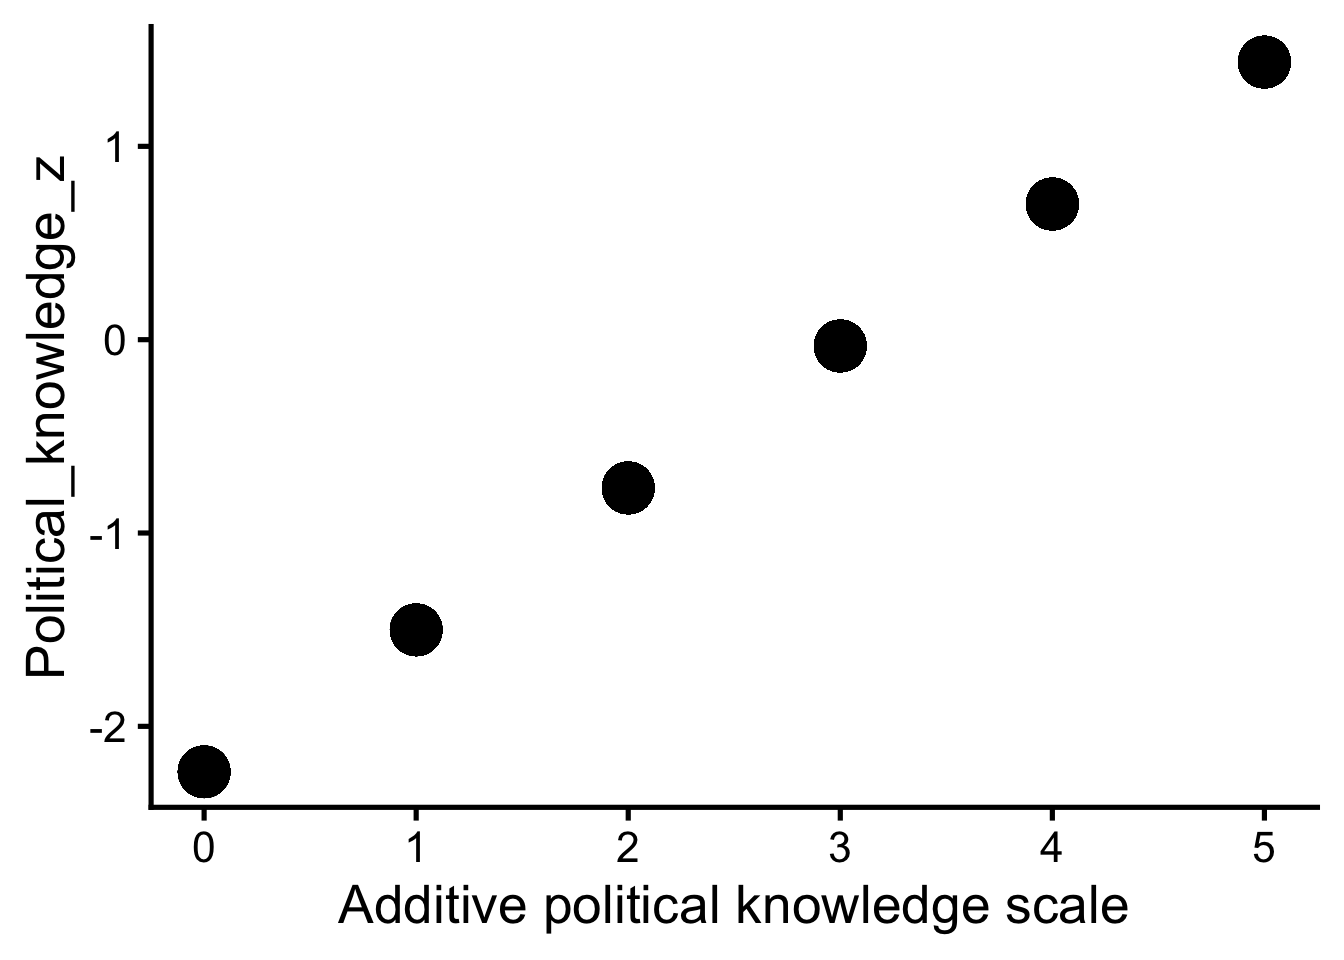
Regression mit Z-standardisierten Variablen
lm(Political_knowledge_z ~ Age_z, data = d) |>
  report_table(metrics = "R2", include_effectsize = FALSE)
Parameter | Coefficient | 95% CI | t(991) | p | Fit
--------------------------------------------------------------------
(Intercept) | 1.49e-16 | [-0.06, 0.06] | 4.92e-15 | > .999 |
Age z | 0.30 | [ 0.24, 0.36] | 10.02 | < .001 |
| | | | |
R2 | | | | | 0.09Regressionstabelle mit standardisierten Koeffizienten
m_pk_age |>
  report_table(metrics = "R2", include_effectsize = TRUE)
Parameter | Coefficient | 95% CI | t(991) | p | Std. Coef.
-----------------------------------------------------------------------
(Intercept) | 1.48 | [1.16, 1.79] | 9.12 | < .001 | 5.13e-16
Age | 0.03 | [0.02, 0.04] | 10.02 | < .001 | 0.30
| | | | |
R2 | | | | |
Parameter | Std. Coef. 95% CI | Fit
--------------------------------------
(Intercept) | [-0.06, 0.06] |
Age | [ 0.24, 0.36] |
| |
R2 | | 0.09log-Transformation
d <- d |>
  mutate(
    Age_log = log(Age),
    Political_knowledge_log = log1p(Political_knowledge)
  )
log-Transformation Plot Age
d |>
  ggplot(aes(Age, Age_log)) +
  geom_point()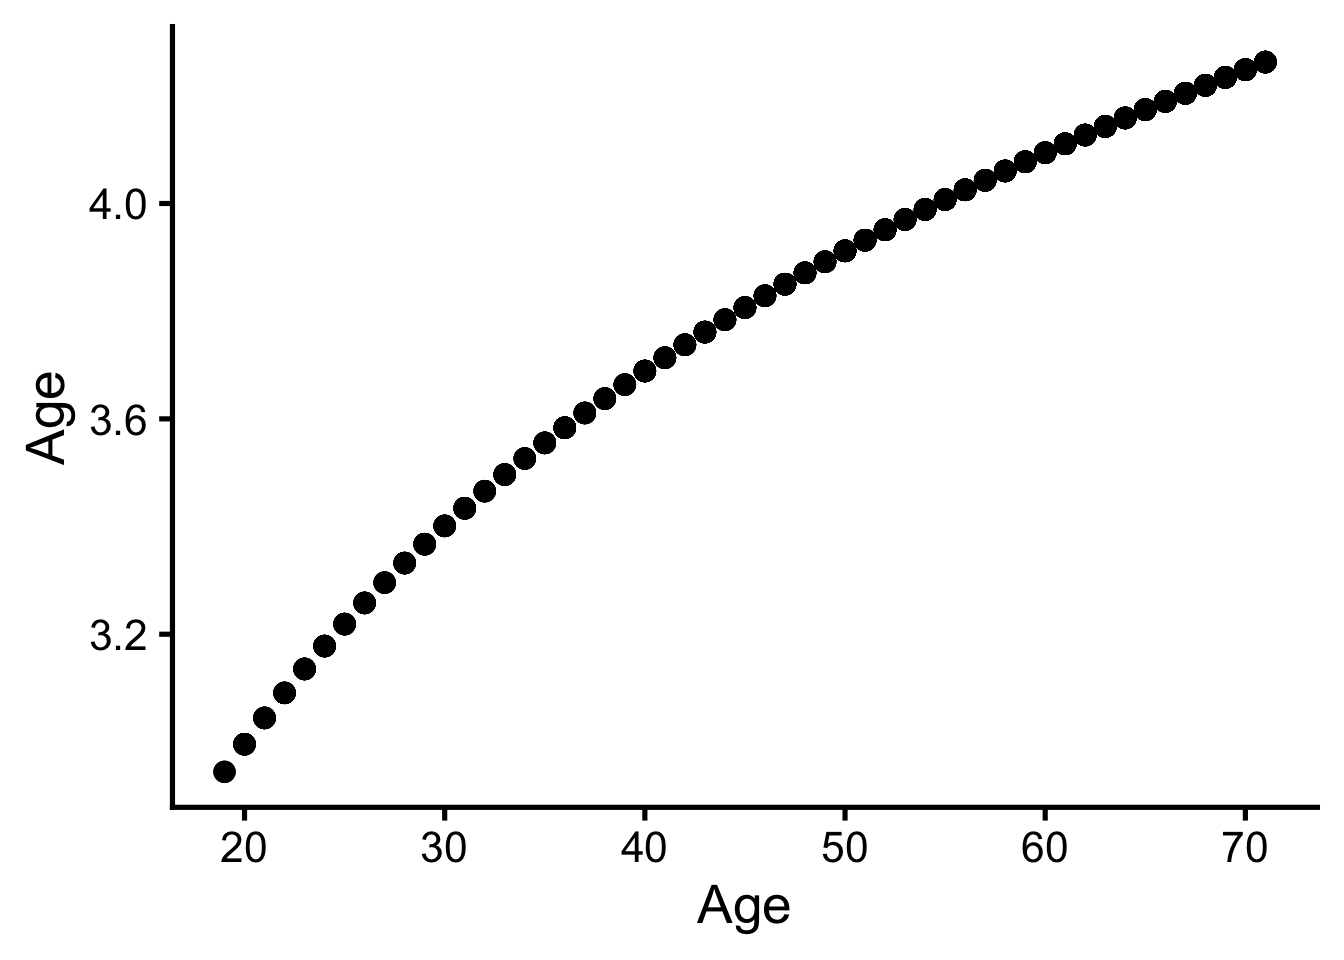
log-Transformation Politisches Wissen
d |>
  ggplot(aes(Political_knowledge, Political_knowledge_log)) +
  geom_point(size = 8)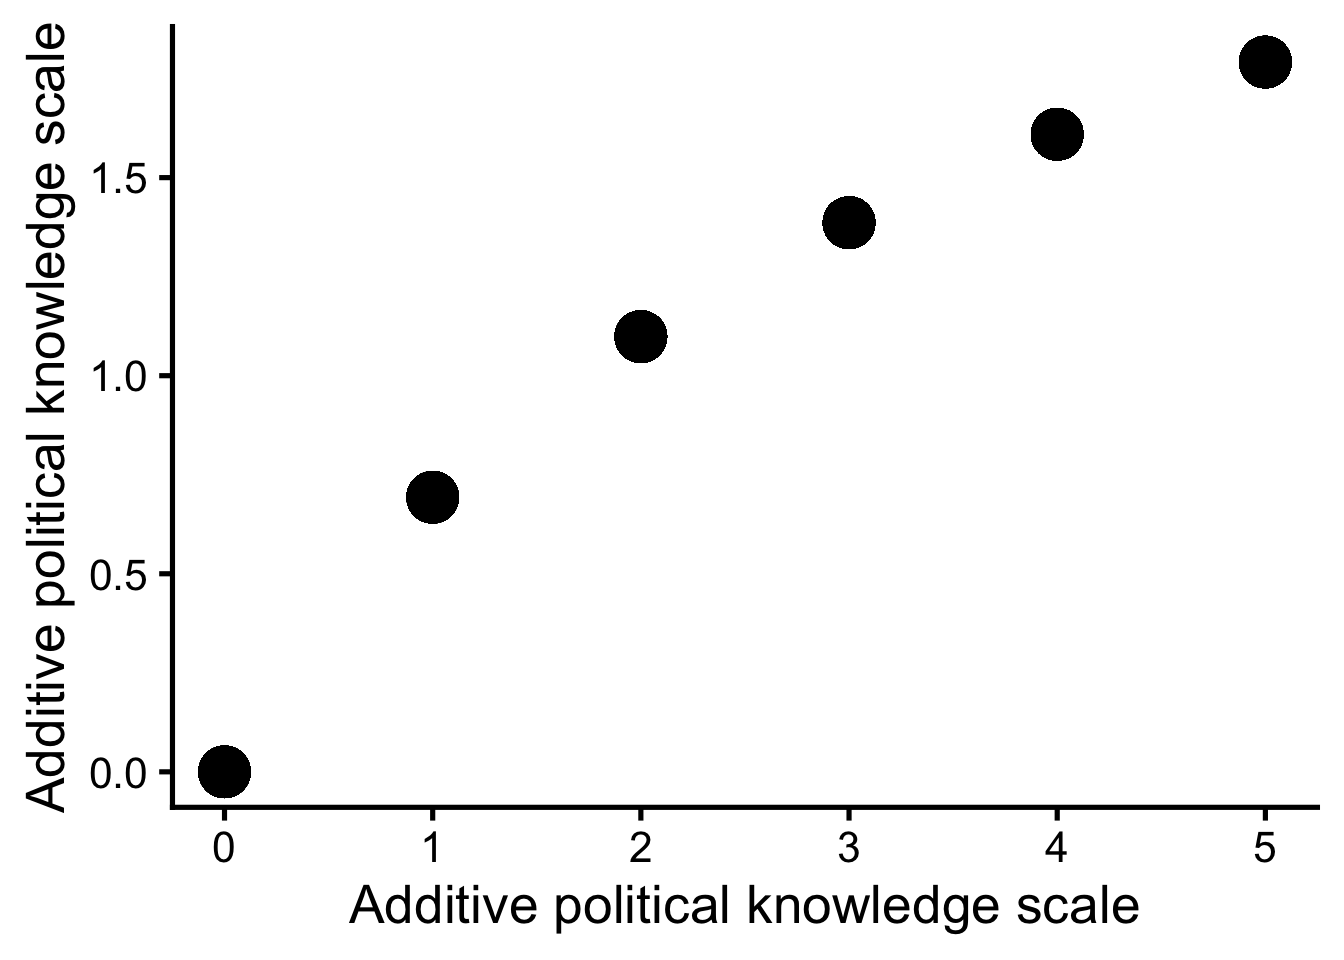
Regression mit log-transformierten Variablen
lm(Political_knowledge_log ~ Age_log, data = d) |>
  report_table(metrics = "R2", include_effectsize = FALSE)
Parameter | Coefficient | 95% CI | t(991) | p | Fit
-------------------------------------------------------------------
(Intercept) | -0.38 | [-0.70, -0.06] | -2.31 | 0.021 |
Age log | 0.43 | [ 0.35, 0.51] | 10.41 | < .001 |
| | | | |
R2 | | | | | 0.106.4 Hausaufgabe
1) Vollziehen Sie die Analysen nach, deren Ausgaben wir in der Vorlesung besprochen haben.
- Schreiben Sie kurze Ergebnistexte zur Beantwortung der Fragen bzw. zum Test der Hypothesen:
- FF: Wie hängen Alter und politisches Wissen in der Stichprobe zusammen?
- H: Je älter eine Person, desto mehr Wissensfragen beantwortet sie richtig.
- H: Männer wissen mehr über Politik als Frauen.
2) Prüfen Sie die Hypothese: Je häufiger eine Person Zeitungen nutzt, desto höher ist ihr politisches Wissen.
- Zeitungsnutzung: Variable
Newspapers - Stellen Sie den Zusammenhang als ‘jittered Scatterplot’ dar.
- Schätzen Sie den Zusammenhang mit einer linearen Regression.
- Sagen Sie das politische Wissen für Personen mit unterdurchschnittlicher, durchschnittlicher und überdurchschnittlicher Zeitungsnutzung voraus.
- Interpretieren Sie die Ergebnisse. Schreiben Sie dazu einen kurzen Text.
- BONUS: Überprüfen Sie, inwiefern das Modell die statistischen Annahmen erfüllt.
- BONUS: Zentrieren Sie die Variable
Newspapersum ihren Mittelwert. Verwenden Sie die neue VariableNewspapers_zin einer Regressionsanalyse und vergleichen Sie die Ergebnisse.
Lösung
- Zu 1) Siehe Code und Ausgaben aus der Vorlesung
- Zu 2) R Skript | HTML mit Output
6.5 Transkript
WarnungHinweise zum automatisiert erstellten Transkript
Das folgende Transkript wurde auf Basis der Aufzeichnung der Vorlesung erstellt. Die vollständigen Aufzeichnungen inklusive der Bildschirminhalte sind in Blackboard🔒 verfügbar. Die Tonspur wurde zuerst mit Hilfe der Werkzeuge des Oral-History.Digital Projekts wörtlich transkribiert. Die wörtliche Transkription wurde in Kombination mit den Vorlesungsfolien mithilfe von Sprachmodellen (v. a. Claude Sonnet 4.5 und GPT 5.2) zu einem übersichtlichen Transkript zusammengefasst. Im Anschluss wurde das Transkript von einer studentischen Hilfskraft überprüft, geglättet und ggf. angepasst. In diesem Prozess kann es an verschiedenen Stellen zu Fehlern kommen. Im Zweifel gilt das gesprochene Wort, und auch beim Vortrag mache ich Fehler.
Ich stelle das Transkript hier als experimentelles, ergänzendes Material zur Dokumentation der Vorlesung zur Verfügung. Noch bin ich mir unsicher, ob es eine sinnvolle Ergänzung ist und behalte mir vor, es weiter zu bearbeiten oder zu löschen.
1. Kontext der Vorlesung und Datensatz
Die Sitzung wiederholt die Grundlagen der bivariaten linearen Regression als Basis für viele spätere Verfahren in der Vorlesung zu Methoden der empirischen Kommunikations- und Medienforschung. Als durchgängiges Beispiel dient der Datensatz von Van Erkel und Van Aelst, in dem politisches Wissen (Anzahl korrekt beantworteter Wissensfragen) u. a. mit dem Alter der Befragten zusammenhängt.
- Datensatz: knapp 1000 Befragte, politisches Wissen als Anzahl richtig beantworteter Fragen (\(0–5\)).
- Wichtige Prädiktoren im Beispiel: Alter in Jahren, später auch Zeitungsnutzung auf einer Skala (z. B. \(0–6\)).
- Ziel der Vorlesung: lineare Zusammenhänge zwischen zwei metrischen oder quasi-metrischen Variablen verstehen und mit Regression beschreiben.
Ziel und Grundidee der bivariaten linearen Regression
Die bivariate lineare Regression beschreibt die Beziehung zwischen genau zwei Variablen: einer abhängigen Variable (Outcome) und einem Prädiktor. Sie fragt, wie sich die durchschnittlichen Werte der abhängigen Variable verändern, wenn sich der Prädiktor ändert, und fasst diesen Zusammenhang als Gerade zusammen.
- Abhängige Variable (\(Y\)): die zu erklärende Größe, etwa politisches Wissen.
- Unabhängige Variable / Prädiktor (\(X\)): erklärende Variable, z. B. Alter in Jahren.
- Fragestellung: „Welcher lineare Zusammenhang besteht zwischen zwei metrischen Variablen?“
Scatterplot, Jitter und Regressionsgerade
Zur Visualisierung wird ein Scatterplot verwendet, in dem jede Person als Punkt eingezeichnet ist. Auf der x-Achse steht der Prädiktor (z. B. Alter), auf der y-Achse die abhängige Variable (z. B. Anzahl richtiger Wissensfragen).
- Viele Personen haben dasselbe Alter und dieselbe Anzahl richtiger Antworten; die Punkte liegen dann genau übereinander.
- Ein „jittered Scatterplot“ verschiebt die Punkte leicht horizontal/vertikal, damit die Punktdichte erkennbar bleibt.
- Durch die Punktewolke wird eine Regressionsgerade gelegt, die den linearen Trend beschreibt.
Regressionsgleichung und Koeffizienten (Intercept und Steigung)
In der bivariaten linearen Regression wird eine Gerade durch die Punkte beschrieben, die durch eine lineare Gleichung mit zwei Koeffizienten definiert ist. Allgemein lautet sie
\(y = b_0 + b_1 x\)
wobei \(b_0\) der Achsenabschnitt (Intercept) und \(b_1\) die Steigung (Slope) ist.
- Intercept \(b_0\): vorhergesagter Wert von \(Y\), wenn \(X = 0\) ist (Schnittpunkt mit der y-Achse).
- Steigung \(b_1\): um wie viele Einheiten sich \(Y\) im Mittel verändert, wenn \(X\) um eine Einheit steigt.
- R-Notation:
lm(Political_knowledge ~ Age, data = d)bedeutet: politisches Wissen wird im Datensatzdaus dem Alter vorhergesagt.
Beispiel „Alter → politisches Wissen“ (nicht standardisiert)
Für das Modell Political_knowledge ~ Age ergibt sich:
- Intercept \(b_0 = 1.48\): vorhergesagtes politisches Wissen für Alter \(= 0\) Jahre (inhaltlich hier wenig sinnvoll).
- Steigung \(b_1 = 0.03\): pro zusätzlichem Lebensjahr steigt die erwartete Zahl richtiger Antworten im Durchschnitt um etwa \(0.03\).
Damit lautet die geschätzte Regressionsgleichung:
\(\text{Political\_knowledge} = 1.48 + 0.03 \cdot \text{Age}\)
Schätzung mit OLS und die Idee der kleinsten Quadrate
Standard ist die OLS-Schätzung (Ordinary Least Squares, Methode der kleinsten Quadrate). Die Idee: Es wird diejenige Gerade gesucht, bei der die Summe der quadrierten Vorhersagefehler (Residuen) minimal ist.
- Beobachteter Wert \(y\): tatsächlicher Messwert (z. B. Anzahl richtiger Antworten einer Person).
- Vorhergesagter Wert \(\hat{y}\): Wert, den das Regressionsmodell für diese Person liefert.
- Residuum \(e = y - \hat{y}\): Vorhersagefehler, also Differenz zwischen Beobachtung und Modellvorhersage.
Zahlenbeispiel mit vier Befragten
In den Folien wird die OLS-Logik mit vier Personen illustriert:
- Person 1: Alter 23, beobachtet \(y = 1\), vorhergesagt \(\hat{y} = 2.16\), Residuum \(e = -1.16\), Fehlerquadrat \(e^2 \approx 1.34\).
- Person 2: Alter 37, \(y = 4\), \(\hat{y} = 2.57\), \(e = 1.43\), \(e^2 \approx 2.04\).
- Person 3: Alter 55, \(y = 2\), \(\hat{y} = 3.10\), \(e = -1.10\), \(e^2 \approx 1.22\).
- Person 4: Alter 62, \(y = 5\), \(\hat{y} = 3.31\), \(e = 1.69\), \(e^2 \approx 2.85\).
Die OLS-Regressionsgerade ist genau die Gerade, für die die Summe der quadrierten Residuen über alle Personen minimal ist; keine andere Gerade führt zu einer kleineren Fehlerquadratsumme.
Erklärte Varianz und \(R^2\)
\(R^2\) („R-Quadrat“) gibt an, wie viel Varianz in der abhängigen Variable durch das Regressionsmodell im Vergleich zu einem sehr einfachen Basismodell (nur Mittelwert) erklärt wird.
- Basismodell: Ohne Prädiktor würde man jeder Person einfach den Mittelwert von \(Y\) vorhersagen (z. B. „3 Fragen korrekt“).
- Regressionsmodell: Nutzt zusätzliche Information (z. B. Alter), um die Vorhersage zu verbessern.
- \(R^2\) misst, um welchen Anteil die Fehlerquadratsumme im Regressionsmodell kleiner ist als im Basismodell.
Im Beispiel „Alter → politisches Wissen“:
- \(R^2 \approx 0.09\): Etwa 9% der Varianz im politischen Wissen werden durch das Alter erklärt; die Vorhersagefehler verringern sich um etwa 9 Prozentpunkte gegenüber dem reinen Mittelwertmodell.
- \(R^2 = 0\): Prädiktor bringt gar keine Verbesserung gegenüber dem Mittelwert.
- \(R^2 = 1\): perfekte lineare Vorhersage – alle Punkte liegen exakt auf der Regressionsgeraden.
Standardisierung, z-Werte und Pearson-Korrelation
Um Koeffizienten besser vergleichbar zu machen, können Variablen z-standardisiert werden. Dabei wird die ursprüngliche Einheit (z. B. „Jahre“ oder „Anzahl richtiger Antworten“) entfernt und alles in Standardabweichungen gemessen.
- z-Standardisierung: Für jede Person wird vom Wert der Mittelwert abgezogen und durch die Standardabweichung geteilt.
- Ergebnis: neue Variable mit Mittelwert \(0\) und Standardabweichung \(1\); Werte geben an, wie viele Standardabweichungen jemand vom Mittel liegt.
- Beispiel: Eine Person mit z-Wert \(-1\) beim Alter ist eine Standardabweichung jünger als der Durchschnitt; \(z = +1\) bedeutet eine Standardabweichung älter.
Im Datensatz:
- Alter: Mittelwert etwa 53 Jahre, Standardabweichung etwa 14 Jahre.
- Politisches Wissen: Standardabweichung etwa \(1.4\) korrekt beantwortete Fragen.
Standardisierter Regressionskoeffizient und Pearsons r
Wenn sowohl Prädiktor als auch abhängige Variable z-standardisiert werden und dann eine Regression gerechnet wird, erhält man einen standardisierten Regressionskoeffizienten.
- In SPSS heißt dieser Koeffizient oft „Beta“, inhaltlich ist es die Steigung zwischen zwei z-standardisierten Variablen.
- Im bivariaten Fall ist dieser standardisierte Koeffizient identisch mit der Pearson-Korrelation \(r\).
Für das Beispiel „Alter → politisches Wissen“ gilt:
- Nicht-standardisiert: \(b_1 \approx 0.03\) zusätzliche richtige Antworten pro Jahr.
- Standardisiert: \(\beta_1 \approx 0.30\); das entspricht \(r \approx 0.30\).
- Interpretation: Wenn das Alter um 1 Standardabweichung steigt, steigt das politische Wissen im Mittel um \(0.30\) Standardabweichungen.
Pearsons \(r\) bewegt sich immer zwischen \(-1\) und \(+1\):
- \(r = -1\): perfekter negativer linearer Zusammenhang.
- \(r = +1\): perfekter positiver linearer Zusammenhang.
- \(r\) nahe \(0\): kein linearer Zusammenhang.
Inferenzstatistik zur Regression und Korrelation
Regression und Korrelation werden nicht nur deskriptiv betrachtet, sondern mit Inferenzstatistik auf eine Grundgesamtheit (z. B. Bevölkerung in Flandern) verallgemeinert.
- Nullhypothese in der Regression: Der Regressionskoeffizient (z. B. von Alter) ist \(0\), es gibt also keinen linearen Zusammenhang in der Population.
- Teststatistik: \(t\)-Wert = Schätzwert / Standardfehler; daraus wird ein \(p\)-Wert berechnet.
- Konfidenzintervall (z. B. 95%): Bereich plausibler Werte des Koeffizienten in der Population.
Beispiel „Alter → politisches Wissen“ in der Regression:
- Nicht-standardisierter Koeffizient: \(0.03\) mit 95%-KI etwa \([0.02; 0.04]\).
- Standardisierter Koeffizient: \(0.30\) mit 95%-KI etwa \([0.24; 0.36]\).
- \(t \approx 10.02\), \(p < 0.001\): Die Nullhypothese „kein Zusammenhang“ wird klar verworfen.
Für die Korrelation:
- \(r \approx 0.30\), \(95\%\)-KI \(\approx [0.25; 0.36]\), \(t(991) \approx 10.02\), \(p < 0.001\).
- Inferenz zu \(r\) und zur standardisierten Regression liefern im bivariaten Fall dieselbe Aussage.
Vorhersagen mit der Regressionsgleichung
Mit der geschätzten Regressionsgleichung lassen sich für beliebige Werte des Prädiktors Vorhersagen für die abhängige Variable berechnen.
- Für einen gegebenen Wert von Age wird \(\hat{y} = 1.48 + 0.03 \cdot Age\) berechnet.
- So kann man aus dem Alter die erwartete Zahl richtig beantworteter Wissensfragen schätzen.
In den Folien werden drei typische Alterswerte betrachtet: eine Standardabweichung unter dem Mittel, der Mittelwert und eine Standardabweichung darüber.
- \(M - 1\) SD: Alter \(\approx 39\) Jahre \(\rightarrow\) erwartetes Wissen \(\approx 2.63\) richtige Antworten.
- \(M\): Alter \(\approx 53\) Jahre \(\rightarrow\) erwartetes Wissen \(\approx 3.04\) richtige Antworten.
- \(M + 1\) SD: Alter \(\approx 67\) Jahre \(\rightarrow\) erwartetes Wissen \(\approx 3.46\) richtige Antworten.
Diese Vorhersagen machen den Effekt greifbar: Zwischen einer eher jüngeren Person (\(M - 1\) SD) und einer durchschnittlich alten Person liegt ein Unterschied von rund \(0.4\) richtig beantworteten Fragen.
Inhaltliche Interpretation: unstandardisiert vs. standardisiert
Nicht-standardisierte und standardisierte Koeffizienten beantworten leicht unterschiedliche, aber verwandte Fragen.
- Nicht-standardisiert: Wie stark ändert sich \(Y\), wenn \(X\) um eine Einheit in seiner ursprünglichen Skala steigt (z. B. 1 Jahr, 1 Skalenpunkt)?
- Standardisiert: Wie stark ändert sich \(Y\) in Standardabweichungen, wenn \(X\) um 1 Standardabweichung steigt?
Im Beispiel „Alter → politisches Wissen“:
- Nicht-standardisiert: Zwei Personen, die sich im Alter um 1 Jahr unterscheiden, unterscheiden sich im Mittel um \(0.03\) richtig beantwortete Fragen.
- Standardisiert: Zwei Personen, die sich im Alter um 1 Standardabweichung unterscheiden, unterscheiden sich um etwa \(0.30\) Standardabweichungen im politischen Wissen.
Standardisierte Koeffizienten sind besonders nützlich, wenn man mehrere Prädiktoren mit unterschiedlichen Skalen in einem Modell vergleichen möchte (z. B. Alter in Jahren und Mediennutzung auf einer Ratingskala).
Deskriptive vs. kausale Interpretation
Die in der Vorlesung vorgestellten Regressionen werden zunächst als deskriptive Modelle verstanden: Sie beschreiben Zusammenhänge in den vorliegenden Daten.
- Eine positive Steigung bedeutet, dass höhere Werte des Prädiktors mit höheren Werten der abhängigen Variable einhergehen.
- Daraus folgt jedoch nicht automatisch, dass der Prädiktor die abhängige Variable ursächlich verändert.
Für eine kausale Interpretation („wenn eine Person älter wird, steigt ihr Wissen um \(0.03\) Fragen“) wären zusätzliche Annahmen und ein geeignetes Design nötig (z. B. Kontrolle von Störvariablen, Längsschnittdaten, Experimente).
Beispiel weiterer Prädiktor: Zeitungsnutzung
Neben dem Alter wird in der Vorlesung auch ein Beispiel mit Zeitungsnutzung als Prädiktor für politisches Wissen angesprochen. Die Logik ist identisch zur Alters-Regression, nur die Skala des Prädiktors ist anders.
- Zeitungsnutzung wird auf einer Skala (z. B. \(0–6\)) gemessen, die die Häufigkeit der Nutzung abbildet.
- Nicht-standardisierter Koeffizient: pro Skalenpunkt der Nutzung steigt die Zahl der richtig beantworteten Fragen im Mittel um etwa \(0.3\).
- Über die gesamte Skala (z. B. von 0 bis 5) ergibt sich so ein Unterschied von etwa \(1.5\) richtig beantworteten Fragen.
- \(R^2\) liegt hier bei rund \(0.11\); das Modell erklärt also etwa 11% der Varianz im politischen Wissen.
Auch hier kann ein standardisierter Koeffizient bzw. eine Korrelation angegeben werden (im Beispiel etwa \(r \approx 0.33\)), die zeigt, dass der Zusammenhang zwischen Zeitungsnutzung und politisches Wissen etwas stärker ist als der zwischen Alter und Wissen.
Verbindung von Korrelation und Regression
Die Pearson-Korrelation \(r\) lässt sich als Spezialfall der bivariaten linearen Regression verstehen.
- Wenn beide Variablen z-standardisiert werden und eine Regression gerechnet wird, ist die Steigung genau der Korrelationskoeffizient \(r\).
- Die Punktewolke ändert sich nicht, nur die Skalenachsen werden transformiert; die Linie bleibt dieselbe, aber ihre Steigung wird in Standardabweichungen ausgedrückt.
Damit ist Korrelation ein Spezialfall der Regression (mit zwei standardisierten Variablen), während die allgemeine lineare Regression sehr viele Varianten und Erweiterungen umfasst (z. B. multiple Regression, nichtlineare Zusammenhänge).
Wichtige Begriffe zum ersten Teil im Überblick (Stichpunkte)
- Abhängige Variable (\(Y\)): zu erklärende Größe, z. B. politisches Wissen.
- Prädiktor / unabhängige Variable (\(X\)): erklärende Variable, z. B. Alter oder Zeitungsnutzung.
- Regressionsgerade: Gerade, die den linearen Zusammenhang zwischen \(X\) und \(Y\) beschreibt und durch OLS geschätzt wird.
- Intercept (\(b_0\)): vorhergesagter \(Y\)-Wert bei \(X = 0\) (Schnittpunkt mit der y-Achse).
- Steigung (\(b_0\)): Veränderung von \(Y\) pro Einheit von \(X\); in der bivariaten Regression der zentrale Zusammenhangsparameter.
- Residuum (\(e\)): Differenz zwischen beobachtetem und vorhergesagtem Wert (\(e = y - \hat{y}\)).
- OLS (Ordinary Least Squares): Schätzverfahren, das die Summe der quadrierten Residuen minimiert.
- \(R^2\): Anteil der durch das Modell erklärten Varianz im Vergleich zum Basismodell mit nur dem Mittelwert; Wertebereich 0–1.
- z-Standardisierung: Transformiert Werte in Einheiten von Standardabweichungen (Mittelwert \(0\), SD \(1\)), um Koeffizienten vergleichbar zu machen.
- Standardisierter Koeffizient: Steigung zwischen standardisierten Variablen; im bivariaten Fall identisch mit Pearson \(r\).
- Pearson-Korrelation \(r\): Maß für die Stärke und Richtung eines linearen Zusammenhangs zwischen zwei metrischen Variablen (\(-1\) bis \(+1\)).
6.6 Wiederholung Regression – Teil 2
In dieser Sitzung wird die bivariate lineare Regression fortgeführt, weil sie die Grundlage für viele weitere statistische Verfahren der empirischen Kommunikations- und Medienforschung bildet. Aufbauend auf den Grundlagen aus der vorherigen Einheit werden drei eher technische, aber zentrale Themen behandelt: der Zusammenhang zwischen Regression und Mittelwertvergleichen, die statistischen Annahmen der Regression und deren Überprüfung sowie die Transformation von Variablen im Regressionsmodell.
- Ziel der Sitzung ist es, die lineare Regression als flexibles Werkzeug zu verstehen, das sowohl metrische als auch binäre Prädiktoren abbilden kann.
- Die Beispiele basieren auf einem Datensatz zum politischen Wissen in Flandern von (0–5 richtig beantwortete Wissensfragen) und Alter als Prädiktor (Van Erkel und Van Aelst).
- Die Inhalte bereiten auf die nächste Einheit zur multiplen linearen Regression mit mehreren Prädiktoren vor.
Regression und Mittelwertvergleich
Ausgangspunkt ist eine bivariate lineare Regression, in der das politische Wissen (Anzahl richtig beantworteter Wissensfragen von 0 bis 5) durch das Alter in Jahren vorhergesagt wird. Die geschätzte Regressionsgerade lautet dabei näherungsweise \(\hat{Y} = 1.48 + 0.03 \times \text{Alter}\), was bedeutet, dass pro zusätzlichem Lebensjahr im Durchschnitt etwa 0.03 Fragen mehr richtig beantwortet werden.
Die zentrale Idee für Mittelwertvergleiche besteht darin, kategoriale Variablen mit zwei Ausprägungen (z. B. Gender) als binäre Dummy-Variablen in das Regressionsmodell einzuführen. Dazu wird eine Gruppierungsvariable wie Gender so umcodiert, dass 0 die Referenzgruppe (hier: Männer) und 1 die Vergleichsgruppe (hier: Frauen) bezeichnet, sodass die Regressionsgleichung Mittelwerte und Differenzen zwischen Gruppen direkt beschreibt.
Im Beispiel zur Zahl richtig beantworteter Wissensfragen ergibt die Regression mit der Dummy-Variablen \(female\) die Gleichung \(\hat{Y} = 3.44 - 0.84 \times female\). Der Intercept 3.44 ist dabei der vorhergesagte Mittelwert für Männer (\(female = 0\)), während der Koeffizient \(-0.84\) angibt, dass Frauen im Durchschnitt 0.84 Fragen weniger richtig beantworten als Männer (\(female = 1\)).
Dieser Unterschied ist statistisch signifikant und entspricht inhaltlich exakt dem Ergebnis eines t-Tests für den Mittelwertvergleich zwischen Männern und Frauen, inklusive einer Effektstärke in der Größenordnung von \(d \approx 0.64\). In der Regression wird also ein Mittelwertvergleich „versteckt“ über eine Dummy-kodierte Variable abgebildet, was später in der multiplen Regression erlaubt, Gruppenunterschiede unter Kontrolle weiterer Prädiktoren (z. B. Alter) zu betrachten.
- Dummy-Variable: Kodierung 0 = Merkmal nicht vorhanden (Referenzgruppe), 1 = Merkmal vorhanden (Vergleichsgruppe).
- Intercept bei Dummy-Prädiktor: Schätzung des Mittelwerts der Referenzgruppe (z. B. Männer bei \(female = 0\)).
- Dummy-Koeffizient: Differenz zwischen Referenzgruppe und Gruppe mit Merkmal (z. B. Frauen haben im Mittel 0.84 Fragen weniger richtig).
- Äquivalenz zum t-Test: In der bivariaten Analyse liefert die Regression denselben Mittelwertunterschied und Test wie ein t-Test für zwei Gruppen.
Statistische Annahmen der linearen Regression
Damit die lineare Regression sinnvolle und verlässliche Inferenz erlaubt, müssen bestimmte statistische Annahmen über die Struktur der Daten erfüllt sein. Diese Annahmen beziehen sich dabei vor allem auf die Residuen, also die Vorhersagefehler der Regression, nicht direkt auf die Rohwerte von Prädiktor und abhängiger Variable.
Neben diesen statistischen Annahmen gibt es Kausalannahmen über die inhaltlich richtige Spezifikation des Modells, also ob relevante Variablen enthalten sind und irrelevante weggelassen wurden; diese werden in einer eigenen Sitzung ausführlich behandelt. In dieser Vorlesungseinheit steht die Diagnose der statistischen Annahmen mithilfe von Grafiken und einfachen Tests im Vordergrund, um Konsequenzen von Verletzungen besser einschätzen zu können.
- Statistische Annahmen: Aussagen über die Form des Zusammenhangs und die Eigenschaften der Residuen im geschätzten Modell.
- Kausalannahmen: Aussagen darüber, ob das Modell inhaltlich die relevanten Variablen und Beziehungen für kausale Interpretationen enthält.
- Ziel der Diagnostik: Erkennen, wann Koeffizienten verzerrt sind oder Standardfehler nicht mehr verlässlich geschätzt werden.
Linearität und Additivität
Linearität bedeutet, dass der Zusammenhang zwischen Prädiktor \(X\) und abhängiger Variable \(Y\) in der Grundgesamtheit näherungsweise durch eine Gerade beschrieben werden kann. Das heißt, eine Erhöhung von \(X\) um eine Einheit führt über den gesamten Wertebereich hinweg zu einer konstanten Änderung von \(Y\), wie im Beispiel der Wissensfragen, wo ein zusätzliches Jahr Alter immer etwa 0.03 Fragen mehr bedeutet.
Additivität bedeutet, dass dieser Zusammenhang zwischen \(X\) und \(Y\) nicht davon abhängt, welchen Wert eine dritte Variable \(Z\) hat, also dass es keine Moderation oder Interaktion gibt, die die Steigung je nach Subgruppe verändert. Wäre etwa der Zusammenhang zwischen Alter und politischem Wissen für Männer und Frauen unterschiedlich stark, wäre die Additivitätsannahme verletzt und eine Moderationsanalyse nötig.
Die Diagnose der Linearität und Additivität erfolgt durch die Betrachtung von Scatterplots und Fitted-Residual-Plots, in denen keine systematischen Krümmungen oder Muster erkennbar sein sollten. Im Beispiel mit Alter und politischem Wissen folgt die Regressionsgerade den Punkten hinreichend gut, und der Verlauf der mittleren Residuen um die Nulllinie deutet auf einen ausreichend linearen Zusammenhang hin.
- Linearität: Gleiche Steigung des Zusammenhangs über den gesamten Wertebereich des Prädiktors (eine Gerade reicht zur Beschreibung).
- Additivität: Der Zusammenhang zwischen \(X\) und \(Y\) ist unabhängig von anderen Variablen \(Z\); anderenfalls liegt eine Moderation vor.
- Diagnose: Scatterplot und Fitted-Residual-Plot, in denen keine systematische Krümmung oder Trends im Fehlerverlauf auftreten sollten.
- Konsequenz bei Verletzung: Verzerrte Regressionskoeffizienten; Abhilfe durch Transformationen, nichtlineare Modelle oder Moderationsanalysen.
Normalverteilung der Residuen
Residuen sind die Differenzen zwischen den beobachteten Werten der abhängigen Variable und den durch das Modell vorhergesagten Werten. Eine zentrale Annahme lautet, dass diese Residuen in der Grundgesamtheit normalverteilt sind, also zufällig um null schwanken und eine annähernde Glockenkurve bilden.
Geprüft wird diese Annahme vor allem über grafische Darstellungen der Residuenverteilung, etwa Dichte- oder Histogrammplots, die eine symmetrische, unimodale Form ohne starke Schiefe oder Ausreißer zeigen sollten. Abweichungen von der Normalverteilung können zu falschen oder ineffizienten Standardfehlern führen und damit Konfidenzintervalle und p-Werte verzerren.
Im Beispiel ist die abhängige Variable „Anzahl richtig beantworteter Wissensfragen“ diskret von 0 bis 5, sodass die Verteilung gezackt wirkt, das zugrunde liegende latente politische Wissen lässt sich aber näherungsweise als normalverteilt denken. Leichte Verletzungen der Normalitätsannahme sind in der Praxis häufig und meist unproblematisch, solange keine extremen Schiefen oder sehr schwere Ausreißer vorliegen.
- Residuen: Vorhersagefehler, also \(e = y - \hat{y}\), die die Abweichung vom durch das Modell erklärten Teil darstellen.
- Normalverteilung: Residuen sollten symmetrisch um null streuen, ohne starke Schiefe oder Mehrgipfligkeit.
- Diagnose: Plots der Residuenverteilung (z. B. Dichteplots, Histogramme).
- Konsequenzen bei Verletzung: Falsche Standardfehler und ineffiziente Schätzung; mögliche Korrektur durch alternative Standardfehler, Datentransformation oder alternative Modelle.
Homoskedastizität der Residuen
Homoskedastizität bedeutet, dass die Varianz der Residuen über alle Werte des Prädiktors hinweg konstant ist. Mit anderen Worten, die Streuung der Fehler um die Regressionsgerade sollte bei niedrigen und hohen Werten von \(X\) ungefähr gleich groß sein, sodass das Modell überall ähnlich gut oder schlecht vorhersagt.
Zur Diagnose werden Fitted-Residual-Plots oder Scale-Location-Plots verwendet, in denen die Größe der Residuen gegen die vorhergesagten Werte aufgetragen wird. Bei Homoskedastizität liegen die Punkte ungefähr gleich breit um eine horizontale Linie; ein trichterförmiges Muster deutet auf Heteroskedastizität hin.
Wird die Homoskedastizitätsannahme verletzt, sind die Standardschätzfehler der Koeffizienten verzerrt, obwohl die Koeffizienten selbst (unter OLS) weiterhin unverzerrt bleiben. Abhilfe schaffen robuste oder alternative Standardfehler, geeignete Datentransformationen oder der Wechsel zu einem Modell, das die Heteroskedastizität explizit berücksichtigt.
- Homoskedastizität: Gleiche Residualvarianz \(Var(e)\) für alle Werte von \(X\).
- Diagnose: Fitted/Residual-Plot oder Scale-Location-Plot ohne systematischen Trend in der Streuung.
- Verletzung (Heteroskedastizität): Streuung der Residuen nimmt systematisch mit dem vorhergesagten Wert zu oder ab.
- Konsequenzen: Falsche Standardfehler und damit unzuverlässige Tests; Gegenmaßnahmen über robuste Standardfehler, Transformationen oder andere Modelle.
Unabhängigkeit der Residuen
Die Unabhängigkeitsannahme fordert, dass die Residuen weder untereinander noch mit den Prädiktoren systematisch korrelieren. Verletzungen treten etwa auf, wenn Beobachtungen geclustert sind (z. B. Personen innerhalb von Schulen, Wellen einer Panelstudie oder Zeitpunkte in einer Zeitreihe) und dadurch ähnliche Fehler teilen.
Ob diese Annahme plausibel ist, wird einerseits über Nachdenken zum Datenerzeugungsprozess geprüft (liegen offensichtliche Cluster oder Abhängigkeiten vor?), andererseits über formale oder grafische Tests, die Zusammenhänge in den Residuen untersuchen. Werden systematische Abhängigkeiten gefunden, sind Standardfehler erneut verzerrt und die Inferenz unsicher.
- Unabhängigkeit: Residuen dürfen keine seriellen, räumlichen oder gruppenspezifischen Muster aufweisen.
- Typische Verletzungen: Geclusterte Daten (z. B. Klassen, Länder, Erhebungswellen) oder Autokorrelation in Zeitreihen.
- Konsequenzen: Falsche Standardfehler, auch wenn Koeffizienten selbst nicht notwendigerweise verzerrt sind.
- Gegenmaßnahmen: Mehrebenen-Modelle, Modelle mit Autokorrelation oder alternative (cluster-robuste) Standardfehler.
Keine einflussreichen Ausreißer
Die Regression setzt voraus, dass alle Beobachtungen in etwa gleich stark zur Schätzung der Regressionsgeraden beitragen. Einzelne extrem liegende Fälle mit hohem Hebel (Leverage) oder großem Residuum können die Lage und Steigung der Geraden stark beeinflussen und damit die Ergebnisse verzerren.
Zur Identifikation solcher einflussreichen Ausreißer dienen Scatterplots mit hervorgehobenen Punkten sowie spezielle Leverage- oder Einflussplots, in denen besonders einflussreiche Fälle sichtbar werden. Werden klar definierte Ausreißer gefunden, können sie nach vorher festgelegten Regeln aus der Analyse entfernt oder gesondert behandelt werden.
- Einflussreicher Ausreißer: Beobachtung, die durch extreme Werte oder Kombinationen von Werten die Schätzung der Regressionsgeraden stark beeinflusst.
- Diagnose: Scatterplots und Leverage-Plots zur Sichtbarmachung auffälliger Fälle.
- Konsequenzen: Verzerrte Koeffizienten und Fehlschlüsse über Richtung und Stärke von Zusammenhängen.
- Umgang: Eventueller Ausschluss von Ausreißern auf Basis transparenter, vorher definierter Kriterien.
Umgang mit Verletzungen der Modellannahmen
In der Praxis sind einige der statistischen Annahmen nahezu immer zumindest leicht verletzt, insbesondere die exakte Normalverteilung der Residuen. Wichtig ist daher weniger, perfekte Erfüllung zu erzwingen, sondern die Art und Schwere der Verletzung zu verstehen und ihre Konsequenzen im Blick zu behalten.
Je nach Annahme kann eine Verletzung zu verzerrten Schätzern, falschen Standardfehlern oder beidem führen, was die Interpretation von Effekten und Signifikanztests erschwert. Viele Probleme lassen sich durch robuste Schätz- und Standardfehler, geeignete Transformationen oder alternative Modellklassen mildern, während Verletzungen der kausalen Annahmen inhaltlich meist gravierender sind.
- Leichte Verletzungen (z. B. leichte Schiefe der Residuen) sind oft unkritisch, wenn sie dokumentiert und bei der Interpretation berücksichtigt werden.
- Stärkere Verletzungen erfordern Korrekturen, etwa robuste Schätzverfahren oder andere Modelle.
- Kausale Fehlannahmen (falsche oder fehlende Variablen) sind für inhaltliche Schlussfolgerungen meist problematischer als moderate Abweichungen von statistischen Annahmen.
Transformation von Variablen im Regressionsmodell
Transformationen von Variablen dienen dazu, die Interpretation von Regressionskoeffizienten zu erleichtern oder Modellannahmen besser zu erfüllen, ohne notwendigerweise den Informationsgehalt der Daten zu verändern. Unterschieden werden lineare Transformationen (Addieren/Subtrahieren oder Multiplizieren/Dividieren mit einer Konstante) und nichtlineare Transformationen (z. B. Quadrieren oder Logarithmieren).
Lineare Transformationen verändern lediglich Skala und Lage (Mittelwert) der Variablen, lassen aber die Passung des Modells, die Varianzaufklärung \(R^2\) und die inferenzstatistischen Schlüsse unverändert. Nichtlineare Transformationen ändern die funktionale Form des Zusammenhangs und können etwa eingesetzt werden, um nichtlineare Beziehungen oder prozentuale Effekte zu modellieren.
- Addieren/Subtrahieren einer Konstante: Verschiebt den Nullpunkt der Skala und damit die Interpretation des Intercepts.
- Multiplizieren/Dividieren mit einer Konstante: Skaliert die Einheit der Variablen und damit die Größe der Koeffizienten.
- Z-Standardisierung: Kombination aus Zentrierung und Skalierung auf Standardabweichungen zur besseren Vergleichbarkeit von Variablen.
- Nichtlineare Transformationen (z. B. Logarithmus): Verändern die Form des Zusammenhangs und ermöglichen Interpretationen in Prozent oder auf multiplikativer Skala.
Zentrieren durch Addieren oder Subtrahieren einer Konstante
Beim Zentrieren wird von jedem Wert einer quasi-metrischen Variable ihr Mittelwert abgezogen, etwa \(Age_c = Age - \overline{Age}\). Dadurch hat die zentrierte Variable einen Mittelwert von null, und der Intercept der Regression gibt den erwarteten Wert der abhängigen Variable für eine Person mit durchschnittlichem Wert auf dem Prädiktor an.
Im Beispiel zur Beziehung zwischen Alter und politischem Wissen führt die Zentrierung dazu, dass der Intercept bei etwa 3.04 liegt, was der vorhergesagten Zahl richtig beantworteter Fragen für Personen mit durchschnittlichem Alter entspricht. Die Steigung von etwa 0.03 bleibt unverändert, weil ein Jahr Altersunterschied weiterhin denselben Unterschied im erwarteten politischen Wissen bedeutet.
Die Modellpassung bleibt identisch: \(R^2\), Standardfehler und Signifikanz der Steigung sind in der zentrierten und unzentrierten Variante gleich. Geändert hat sich lediglich die Interpretation des Intercepts, der nun einen inhaltlich sinnvollen Referenzpunkt (durchschnittliches Alter statt Alter = 0) beschreibt.
- Zentrierung: \(X_c = X - \overline{X}\); der Mittelwert wird auf null gesetzt.
- Intercept nach Zentrierung: Erwarteter Wert von \(Y\) für eine Person mit durchschnittlichem Wert auf \(X\).
- Steigung: Unverändert, da Abstände auf der Skala gleich bleiben.
- Nutzen: Erleichtert die Interpretation, insbesondere in Modellen mit Interaktionen und mehreren Prädiktoren.
Skalieren durch Multiplizieren oder Dividieren
Durch Multiplizieren oder Dividieren mit einer Konstante wird die Einheit einer Variablen verändert, ohne ihren Informationsgehalt zu ändern. Im Beispiel wird das Alter durch 10 geteilt, sodass \(Age\_10 = Age / 10\) eine Einheit von zehn Jahren statt einem Jahr hat.
Die Form des Zusammenhangs bleibt identisch, aber der Regressionskoeffizient ändert sich entsprechend der neuen Einheit. Anstelle von 0.03 Fragen pro zusätzlichem Jahr ergibt sich etwa 0.30 zusätzlich richtig beantwortete Fragen pro zehn Jahre Altersunterschied, was inhaltlich oft leichter zu kommunizieren ist.
Wichtig ist, dass sich weder \(R^2\) noch die inferenzstatistischen Tests ändern: Die erklärte Varianz, die t-Werte, p-Werte und Konfidenzintervalle bleiben gleich, nur die Skala des Koeffizienten und damit seine verbale Interpretation ändern sich.
- Skalierung: Division oder Multiplikation mit einer Konstante ändert die Einheit (z. B. Jahre → Jahrzehnte).
- Effekt auf den Koeffizienten: Der numerische Wert des Koeffizienten passt sich der neuen Einheit an (hier von 0.03 auf 0.30).
- Effekt auf Modellgüte: \(R^2\) und Signifikanztests bleiben unverändert.
- Nutzen: Erlaubt eine anschaulichere Interpretation in inhaltlich sinnvollen Einheiten.
Z-Standardisierung
Die Z-Standardisierung kombiniert Zentrierung und Skalierung, indem zunächst der Mittelwert abgezogen und anschließend durch die Standardabweichung geteilt wird. Formal gilt \(Z_X = (X - \overline{X}) / SD(X)\), sodass die transformierte Variable einen Mittelwert von null und eine Standardabweichung von eins hat.
In der Regression bedeutet ein Koeffizient für einen z-standardisierten Prädiktor, um wie viele Standardabweichungen sich die abhängige Variable verändert, wenn der Prädiktor um eine Standardabweichung steigt. Im Beispiel entspricht der standardisierte Koeffizient für Alter etwa 0.30, was heißt, dass eine Standardabweichung mehr Alter mit 0.30 Standardabweichungen mehr politischem Wissen einhergeht.
In der bivariaten linearen Regression ist der standardisierte Regressionskoeffizient identisch mit dem Pearson-Korrelationskoeffizienten \(r\). Entsprechend ergibt sich hier \(r \approx 0.30\), also ein positiver, mittlerer Zusammenhang zwischen Alter und politischem Wissen.
- Z-Standardisierung: \(Z_X = (X - \overline{X}) / SD(X)\), Mittelwert = 0, Standardabweichung = 1.
- Standardisierter Koeffizient: Veränderung von \(Y\) in Standardabweichungen bei einer Standardabweichung Veränderung in \(X\).
- Zusammenhang zu \(r\): In der bivariaten linearen Regression entspricht der standardisierte Koeffizient genau dem Korrelationskoeffizienten.
- Nutzen: Vergleichbarkeit der Stärke von Effekten über Variablen mit unterschiedlichen Skalen hinweg.
Nichtlineare Transformationen: Logarithmen und Log-Log-Modelle
Nichtlineare Transformationen wie das Logarithmieren von Variablen verändern die Form des Zusammenhangs und ermöglichen Interpretationen in relativen oder prozentualen Änderungen. Im Beispiel werden sowohl das Alter als auch das politische Wissen (plus 1, um mit Nullwerten umgehen zu können) logarithmiert, sodass ein Log-Log-Modell geschätzt wird.
Im Log-Log-Modell ergibt sich eine Regressionsgleichung mit einem Koeffizienten für \(log(Age)\) von etwa 0.43. Dieser Wert lässt sich so interpretieren, dass eine Person, die um 1 Prozent älter ist, ungefähr 0.43 Prozent mehr Wissensfragen korrekt beantwortet, beziehungsweise dass eine Verdopplung des Alters mit grob 43 Prozent mehr richtig beantworteten Fragen einhergeht.
Die logarithmische Transformation führt typischerweise zu einer Kurve, die bei kleinen Werten von \(X\) steiler verläuft und bei größeren Werten abflacht, sodass Unterschiede bei jüngeren Personen stärker ins Gewicht fallen als bei sehr alten. Solche Transformationen sollten jedoch nur verwendet werden, wenn sie inhaltlich sinnvoll sind und die Datenstruktur (z. B. positive Werte, Verhältnisskalen) es zulässt.
- Log-Transformation: Anwendung des Logarithmus auf Variablen, oft mit \(log1p(Y) = log(Y + 1)\) zur Behandlung von Nullwerten.
- Log-Log-Modell: Sowohl Prädiktor als auch abhängige Variable sind logarithmisch transformiert; Koeffizienten werden als Elastizitäten (Prozent-zu-Prozent-Effekte) interpretiert.
- Beispielinterpretation: Eine Verdopplung des Alters führt näherungsweise zu 43 Prozent mehr richtig beantworteten Fragen.
- Voraussetzung: Variablen müssen positiv und inhaltlich sinnvoll logarithmierbar sein; Transformationen sollten begründet werden.
Zusammenfassung und Ausblick
Die lineare Regression beschreibt Zusammenhänge, indem sie Linien durch Datenpunkte legt, deren Steigung die Stärke und Richtung des Zusammenhangs quantifiziert. Diese Grundidee trägt sowohl die bivariate Regression mit einem Prädiktor als auch die multiple Regression mit mehreren Prädiktoren, die in den nächsten Sitzungen eingeführt wird.
In dieser Einheit wurde gezeigt, dass einfache Mittelwertvergleiche (z. B. zwischen Männern und Frauen) als Spezialfälle der Regression mit Dummy-Variablen verstanden werden können und dass wichtige statistische Annahmen sowie Transformationen der Variablen für Interpretation und Güte der Modelle entscheidend sind. Die vorgestellten Diagnosen und Transformationen sind hilfreiche Werkzeuge, aber nicht in jedem Detail klausurrelevant, während das Verständnis der Regressionsgrundlagen für einen Großteil der weiteren Inhalte essenziell bleibt.
- Regression verallgemeinert Mittelwertvergleiche und erlaubt die gleichzeitige Berücksichtigung metrischer und binärer Prädiktoren.
- Statistische Annahmen betreffen vor allem die Residuen und beeinflussen Standardfehler und Inferenz, während kausale Annahmen über die inhaltliche Interpretation entscheiden.
- Transformationen von Variablen ändern Interpretationen und können Annahmen besser erfüllen, ohne notwendigerweise den Informationsgehalt oder die erklärte Varianz zu verändern.
- Nächster Schritt in der Vorlesung ist die multiple lineare Regression, in der mehrere Prädiktoren gleichzeitig modelliert werden.